Immagina questo scenario: venerdì sera, ore 21:00. Il traffico sul tuo e-commerce retail è al suo picco settimanale. All'improvviso, un data center in Europa subisce un'interruzione di corrente, oppure un bug imprevisto manda in crash l'infrastruttura di un partner esterno, o ancora le API di Shopify o Stripe smettono di rispondere per quaranta minuti. Se il tuo e-commerce si affida a un team tradizionale o a integrazioni software rigide e prive di ridondanza, in quel preciso istante il tuo business si ferma. Le vendite si azzerano, i carrelli vengono abbandonati e il costo di acquisizione clienti (CAC) pagato per portare quel traffico sul sito viene interamente sprecato.
Quando decidi di implementare un AI Team per automatizzare e scalare le operazioni del tuo e-commerce, una delle domande più critiche che devi porti come investitore e decisore aziendale non riguarda solo le performance di vendita o l'incremento del tasso di conversione. La vera domanda strategica è: cosa succede se il sistema va down? Quali sono i protocolli di sicurezza che garantiscono che la tua azienda continui a fatturare anche durante un crash infrastrutturale del cloud o delle terze parti?
In GTAVIANI Consulting non consideriamo l'intelligenza artificiale come un semplice applicativo software isolato, bensì come un'infrastruttura di livello enterprise. Per questo motivo, ogni AI Team che progettiamo e supervisioniamo integra nativamente un piano di Disaster Recovery (DR) e di Business Continuity (BC) studiato appositamente per le esigenze del retail medio-grande.
La vulnerabilità dei sistemi tradizionali e il rischio di fermo macchina
Nel retail e-commerce, ogni minuto di inattività ha un impatto finanziario immediato e misurabile sul conto economico. Nonostante ciò, molte medie imprese italiane gestiscono la propria presenza digitale con un livello di vulnerabilità tecnologica estremamente elevato. Le agenzie esterne spesso configurano i sistemi su server singoli o all'interno di un'unica area geografica, senza meccanismi di failover automatico. In caso di disservizio del provider di hosting, il tempo necessario per accorgersi del problema, allertare i tecnici, identificare la causa e ripristinare manualmente il servizio può variare da alcune ore a diversi giorni.
Nel linguaggio tecnico del risk management e della business continuity, questo impatto viene misurato attraverso due metriche fondamentali:
- RTO (Recovery Time Objective): Il tempo massimo tollerabile che può trascorrere tra il verificarsi del disservizio e il completo ripristino dell'operatività del sistema.
- RPO (Recovery Point Objective): La quantità massima di dati che l'azienda può permettersi di perdere in termini di tempo prima che si verifichi il disastro (ad esempio, la perdita delle transazioni o delle interazioni degli utenti registrate negli ultimi minuti o ore).
Per un e-commerce retail con milioni di euro di fatturato annuo, un RTO di ore e un RPO di un giorno sono semplicemente inaccettabili. Se un assistente virtuale AI o un Pricing Agent smette di funzionare improvvisamente, non si perde solo una tecnologia: si rischia di perdere la sincronizzazione dei prezzi, l'invio delle email di recupero carrello e il supporto clienti in tempo reale, con un conseguente crollo istantaneo della fiducia del consumatore.
Il Piano di Disaster Recovery di GTAVIANI: i 4 Pilastri della Resilienza
Per mitigare questi rischi e assicurare un'affidabilità di livello aziendale, la nostra consulenza prevede il disegno di un'architettura resiliente basata su quattro pilastri fondamentali, implementati direttamente sui cloud provider leader di mercato come Google Cloud Platform (GCP) e Amazon Web Services (AWS).
1. Ridondanza Multi-Regione e Failover Automatico in meno di 5 Secondi
La stragrande maggioranza dei servizi digitali economici è ospitata in modalità "Single-Region", ovvero su un unico centro di calcolo. Se quella specifica regione geografica ha un problema (un incendio, un'interruzione di rete o un sovraccarico), l'applicazione muore.
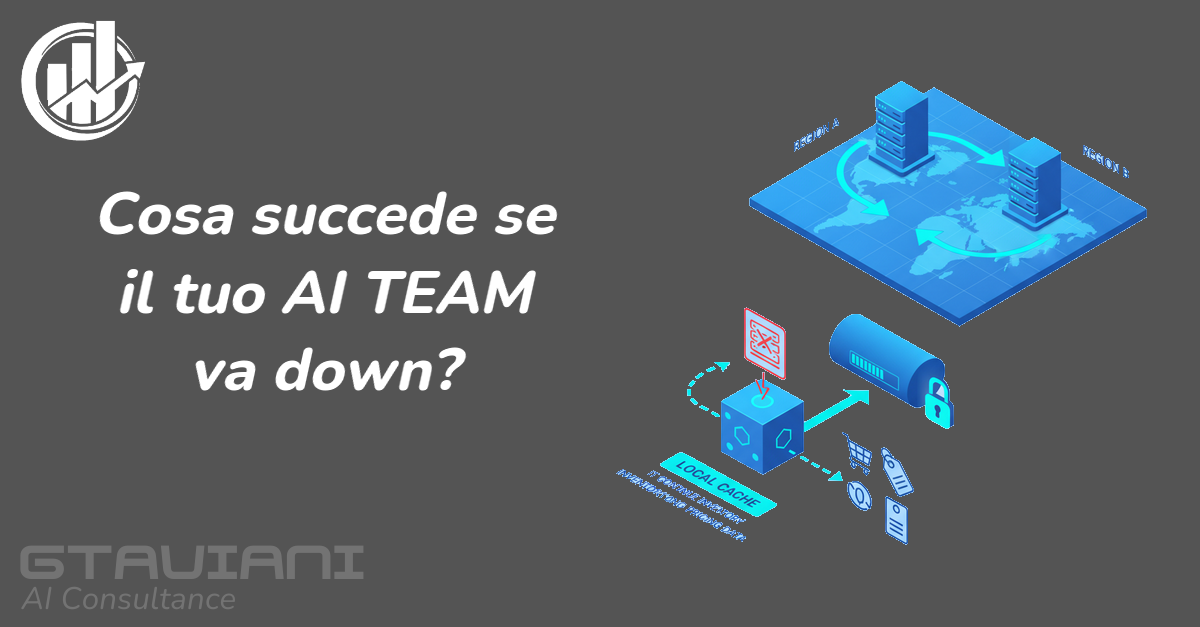
Gli agenti AI del tuo AI Team di GTAVIANI sono invece distribuiti e ridondati in modalità Multi-Region Active-Active o Hot Standby. L'infrastruttura viene sdoppiata su regioni geografiche separate, come ad esempio la regione eu-west (Europa) e la regione us-central (Stati Uniti). Attraverso un sistema di Global Load Balancing (GLB) con un indirizzo Anycast IP unico a livello globale, il traffico degli utenti viene costantemente indirizzato verso il data center più vicino e performante.
Nel caso in cui una delle regioni subisca un downtime totale o un rallentamento anomalo, il bilanciatore di carico globale rileva istantaneamente il fallimento tramite controlli di salute (health checks) continui e reindirizza in modo automatico il 100% del traffico sulla regione secondaria sana. Questo processo di failover automatico richiede menos di 5 secondi, garantendo che gli utenti finali sul tuo sito non percepiscano alcuna interruzione nel servizio degli agenti AI.
2. Protezione del Dato e Backup Giornalieri Cifrati con Ripristino in meno di un'Ora
Il secondo scenario di rischio riguarda la corruzione dei dati o la perdita accidentale di informazioni cruciali, come le policy degli agenti, i cataloghi prodotti ottimizzati, le risposte storiche del customer service o i dataset di addestramento. Una cancellazione accidentale o un attacco informatico potrebbero paralizzare le operazioni.
Per rispondere a questa minaccia, l'architettura di GTAVIANI prevede un sistema di backup automatico e incrementale giornaliero, cifrato con chiavi di sicurezza avanzate (AES-256). Tutti i database transazionali e le configurazioni del team di agenti sono replicati in tempo reale su archivi geo-ridondanti (Cloud Storage multi-regionale), protetti da criteri di immutabilità temporale che impediscono la sovrascrittura o la cancellazione fraudolenta.
Grazie alla tecnologia Point-in-Time Recovery (PITR), siamo in grado di ricostruire lo stato esatto del sistema a qualsiasi secondo specifico delle ultime due settimane. In caso di emergenza grave sui dati, il nostro Recovery Point Objective (RPO) garantisce il ripristino completo del team operativo in meno di un'ora, azzerando quasi totalmente il rischio di perdita di informazioni vitali per il business.
3. Gestione dei Vendor Crash: Cache Locale per un'Operatività Offline di 4 Ore
Cosa succede se il problema non risiede nell'infrastruttura degli agenti, ma in uno dei servizi esterni a cui sono collegati? Ad esempio, un blocco improvviso delle API di Shopify, un disservizio di Stripe che impedisce di verificare i pagamenti, o un crash del gestionale ERP aziendale.
In una configurazione standard, se un software terzo smette di rispondere, l'intero sistema va in errore a catena. Gli agenti di GTAVIANI sono invece progettati seguendo il principio del "decoupling" (disaccoppiamento) e della resilienza locale. Ogni agente mantiene una copia locale temporanea (cache distribuita ad alta velocità) contenente i dati essenziali all'operatività ordinaria, come l'inventario dei prodotti, le regole di pricing principali e le sessioni attive dei carrelli.
In caso di crash del fornitore esterno (ad es. Shopify), gli agenti AI non si bloccano: continuano a operare offline utilizzando la cache locale per un periodo massimo di 4 ore. Le transazioni e le interazioni effettuate dai clienti durante questo intervallo vengono accodate in modo sicuro all'interno di un sistema di messaggistica asincrono resiliente (Cloud Pub/Sub). Non appena il fornitore esterno torna online, gli agenti avviano un processo automatico di sincronizzazione e riconciliazione dei dati accumulati. In questo modo, l'e-commerce continua a vendere senza sosta, garantendo la continuità aziendale anche a fronte di instabilità dei colossi del software.
4. Infrastruttura GTAVIANI e Garanzia SLA del 99,9%
L'affidabilità di un'infrastruttura tecnologica si misura nei numeri scritti nei contratti. GTAVIANI garantisce per la propria infrastruttura di orchestrazione proprietaria un Service Level Agreement (SLA) di uptime pari al 99,9% su base annuale.
Un uptime del 99,9% significa che la nostra infrastruttura tollera un massimo di 8,7 ore di downtime complessivo all'anno, incluse le finestre di manutenzione programmata (che vengono comunque eseguite negli orari di minor traffico assoluto, tipicamente tra le 02:00 e le 04:00 del mattino). Se per qualsiasi motivo l'uptime scende al di sotto di questa soglia concordata, il contratto di GTAVIANI prevede penali finanziarie e compensazioni strutturate sotto forma di crediti di servizio, allineandoci perfettamente ai massimi standard di affidabilità del mercato enterprise.
Il Worst-Case Scenario: Come un E-commerce Continua a Vendere
Nel peggiore dei casi immaginabili (ad esempio, un crash simultaneo di più API e un blocco parziale della rete), il sistema è ingegnerizzato per degradare le proprie funzioni in modo controllato (Graceful Degradation), anziché bloccarsi del tutto.
In questa situazione estrema, gli agenti continuano a lavorare offline servendosi di dati storici vecchi al massimo di 4 ore. Il Pricing Agent non aggiornerà i prezzi in tempo reale in base ai concorrenti, ma applicherà l'ultimo listino valido memorizzato nella cache; il Recommender Agent continuerà a mostrare i prodotti consigliati basandosi sui dati pre-elaborati invece che sul tracciamento live al millisecondo; il Support Agent informerà i clienti con cortesia che i sistemi sono in manutenzione ma prenderà nota della richiesta per risolverla non appena i server saranno ripristinati. L'esperienza d'acquisto dell'utente non viene interrotta bruscamente: l'e-commerce continua a vendere, riducendo drasticamente le perdite economiche.
Conclusione: La Resilienza come Metodo di Business
Garantire l'uptime e la sicurezza di un sistema di intelligenza artificiale non è un aspetto secondario da delegare ai tecnici solo quando si verifica un problema. Al contrario, la business continuity deve essere integrata fin dal primo giorno nella strategia aziendale.
GTAVIANI progetta l'infrastruttura dei tuoi agenti su regioni multiple, con failover automatico, backup giornalieri cifrati e cache locale che tiene operativo l'e-commerce anche se un fornitore va giù. La continuità del business fa parte dello stesso metodo con cui disegniamo e supervisioniamo ogni AI Team — non solo performance, anche resilienza.
Fonti
- Google Cloud Architecture: Disaster Recovery Planning Guide
Un'analisi approfondita sui pattern di architettura multi-regione, calcolo dell'RTO/RPO e strategie di failover su infrastruttura cloud globale.
URL: https://cloud.google.com/architecture/disaster-recovery-planning-guide - AWS Whitepapers: Disaster Recovery of Workloads on AWS
Linee guida ufficiali di Amazon Web Services sulle migliori pratiche per implementare la business continuity e ridurre al minimo i tempi di inattività aziendale.
URL: https://docs.aws.amazon.com/whitepapers/latest/disaster-recovery-workloads-on-aws/disaster-recovery-workloads-on-aws.html